LLMはどのくらい速い?速度の統計
2026年11月16日時点のデータ · 最終更新 · BenchLeader
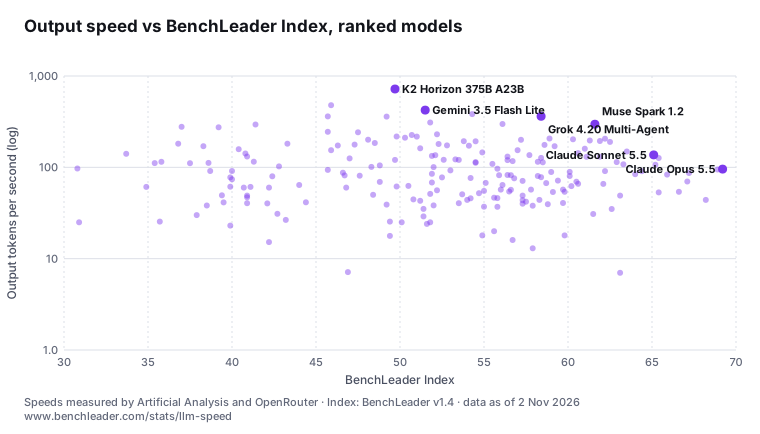
BenchLeaderでランク付けされたモデルの出力速度は中央値で約82トークン/秒、回答を始めるまでの時間(最初のトークンまでの時間)は中央値1.1秒です。測定はArtificial Analysis、OpenRouterによるものです。BenchLeaderが追跡する中で最速のモデルはCeleris-1で、約800トークン/秒(Artificial Analysis)です。BenchLeader Indexが60以上のモデルでは、Muse Spark 1.2が約210トークン/秒で最速です。
主な統計
各統計には個別のリンク(#)があり、そのまま引用できます。
- ランク付けされたモデルの出力速度は中央値で約82トークン/秒で、速度の測定値があるランキング入りの210モデルが対象です(Artificial Analysis、OpenRouterによる測定、BenchLeader、2026年11月16日)。 #
- 最初のトークンまでの時間の中央値は1.1秒で、ランキング入りの189モデルが対象です(OpenRouter、Artificial Analysisによる測定、BenchLeader、2026年11月16日)。 #
- BenchLeaderが追跡する中で最速のモデルはCelerisのCeleris-1で、約800トークン/秒です(Artificial Analysis、BenchLeader、2026年11月16日)。 #
- BenchLeader Indexが60以上のランキング入りのモデルで最速なのはMuse Spark 1.2で、約210トークン/秒です(Artificial Analysis、BenchLeader、2026年11月16日)。 #
- Indexが60以上のランキング入りのモデルで最初のトークンまでの時間が最も短いのはClaude Opus 4.8の0.77秒です(OpenRouter、BenchLeader、2026年11月16日)。 #
- ランキング入りのモデル全体で最初のトークンまでの時間が最も短いのはLlama 3.2 3B Instructの0.21秒です(OpenRouter、BenchLeader、2026年11月16日)。 #
- BenchLeader Indexの首位であるClaude Fable 5.2の出力速度は約110トークン/秒、最初のトークンまでの時間は3.9秒です(出力速度はArtificial Analysis、最初のトークンまでの時間はOpenRouterによる測定。BenchLeader、2026年11月16日)。 #
品質帯ごとの最速モデル
| Index帯 | 速度の測定値があるモデル | 最速モデル | トークン/秒 | 測定元 |
|---|---|---|---|---|
| 65+ | 10 | Claude Opus 5.5 Anthropic | 120 | Artificial Analysis |
| 60–65 | 27 | Muse Spark 1.2 Meta | 210 | Artificial Analysis |
| 55–60 | 55 | Grok 4.20 Multi-Agent SpaceXAI | 350 | OpenRouter |
| 50–55 | 42 | Muse Ember Meta | 440 | Artificial Analysis |
| 45–50 | 29 | Mercury 2 Inception | 350 | Artificial Analysis |
出力速度が最も速いモデル
ランキング入りのモデル(BenchLeader Indexがあるモデル)だけを載せています。速度のリーダーボードにはIndexのないモデルも載っているため、全体で最速のモデルがここに出てこないことがあります。
| # | モデル | Index | トークン/秒 | 測定元 |
|---|---|---|---|---|
| 1 | Muse Ember Meta | 52.1 | 440 | Artificial Analysis |
| 2 | Grok 4.20 Multi-Agent SpaceXAI | 58.5 | 350 | OpenRouter |
| 3 | Mercury 2 Inception | 49.2 | 350 | Artificial Analysis |
| 4 | Gemini 3.5 Flash Lite Google | 51.4 | 310 | Artificial Analysis |
| 5 | Gemini 3.1 Flash Lite Google | 52.6 | 300 | Artificial Analysis |
| 6 | Beam 1.0 Reflection | 45.9 | 290 | Artificial Analysis |
| 7 | Nemotron 3.5 Super VL NVIDIA | 45.8 | 270 | Artificial Analysis |
| 8 | Nemotron 3.5 Lightning NVIDIA | 41.4 | 270 | Artificial Analysis |
| 9 | Claude Haiku 5.5 Anthropic | 56.7 | 230 | Artificial Analysis |
| 10 | Nova Micro Amazon | 39.2 | 210 | Artificial Analysis |
最初のトークンまでの時間が短いモデル
最初のトークンまでの時間が最も短い、ランキング入りのモデルです。すべてのモデルはレイテンシのリーダーボードをご覧ください。
| # | モデル | Index | 最初のトークンまでの時間 | 測定元 |
|---|---|---|---|---|
| 1 | Llama 3.2 3B Instruct Meta | 35.6 | 0.21秒 | OpenRouter |
| 2 | Llama 3.2 1B Instruct Meta | 30.6 | 0.23秒 | OpenRouter |
| 3 | Command A+ Cohere | 45.9 | 0.23秒 | OpenRouter |
| 4 | Nemotron 3 Ultra 550B A55B NVIDIA | 55.4 | 0.25秒 | OpenRouter |
| 5 | Phi-4 Microsoft | 39.3 | 0.27秒 | OpenRouter |
| 6 | Qwen3 30B A3B 2507 Alibaba | 48.0 | 0.28秒 | OpenRouter |
| 7 | Nemotron 3.5 Lightning NVIDIA | 41.4 | 0.30秒 | OpenRouter |
| 8 | Mistral Small 3 Mistral AI | 39.2 | 0.30秒 | OpenRouter |
| 9 | GLM 4.7 Flash Zhipu AI | 51.0 | 0.31秒 | OpenRouter |
| 10 | Granite 4.2 8B IBM | 41.1 | 0.31秒 | OpenRouter |
数値の算出方法
出力速度は、回答が始まってからモデルが1秒あたりに生成するトークン数の中央値です。Artificial Analysisが測定しているモデルではその中央値を、それ以外はOpenRouterの実トラフィックの中央値を7日間で平滑化したものを使っています。最初のトークンまでの時間は、各表で測定元を明記しています。OpenRouterの値には思考フェーズは含まれません。中央値は、ランキング入りのモデル(BenchLeader Indexがあるモデル)を、それぞれ最もスコアの高い構成で集計したものです。
速度はモデルを提供するプロバイダー、負荷、プロンプトによって変わるため、数値は保証値ではなく目安としてご覧ください。出典の詳細は算出方法にあります。
この統計を引用する
速度はArtificial Analysis、OpenRouterによる測定値を、出典を明記して掲載しています。測定元の利用条件が適用され、再利用のためには提供していません。このページでBenchLeader独自の数値はIndexのスコアと中央値です。引用には下記のページ情報をお使いください。
引用
BenchLeader「LLMの速度統計」2026年11月16日時点のデータ、https://www.benchleader.com/ja/stats/llm-speedよくある質問
- LLMの速度は毎秒何トークンですか?
- BenchLeaderでランク付けされたモデルの出力速度は中央値で約82トークン/秒です(Artificial Analysis、OpenRouterによる測定)。追跡対象で最速のCeleris-1は約800トークン/秒に達します。
- 最初のトークンまでの時間は、一般的にどのくらいですか?
- ランキング入りの189モデルの中央値で1.1秒です(OpenRouter、Artificial Analysisによる測定)。OpenRouterの最初のトークンまでの時間には、思考フェーズは含まれません。
- 高品質で最速のLLMは?
- MetaのMuse Spark 1.2です。BenchLeader Indexが60以上のランキング入りのモデルの中で、約210トークン/秒(Artificial Analysis)です。
- これらの速度はどこから来ていますか?
- 出力速度は、Artificial Analysisが測定しているモデルではその中央値を、それ以外はOpenRouterの実トラフィックの中央値を7日間で平滑化したものを使っています。最初のトークンまでの時間は主にOpenRouterの値です。各数値は測定元のクレジット付きで掲載し、その利用条件に従います。BenchLeaderが再ライセンスすることはありません。