飽和しているAIベンチマークは?
2026年11月16日時点のデータ · 最終更新 · BenchLeader
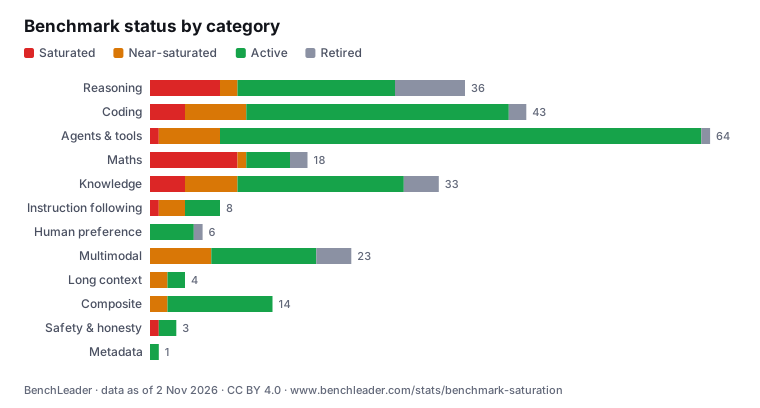
BenchLeaderが追跡する285件のベンチマークのうち、34件が飽和、39件が飽和に近い状態です。上位モデルのスコアが上限に近すぎて、差を見分けられません。パーセント表示のボードは、5位のモデルが90%以上になると飽和とみなします。現役のボードは188件、更新停止(1年間新しい結果がない)は24件です。最も飽和が進んでいるのは数学のボードで、21件中11件です。
主な統計
各統計には個別のリンク(#)があり、そのまま引用できます。
- BenchLeaderが追跡する285件のベンチマークの内訳は、飽和34件、飽和に近い39件、現役188件、更新停止24件です(BenchLeader、2026年11月16日)。 #
- 飽和したボードの割合が最も大きいカテゴリは数学で、21件中11件です(BenchLeader、2026年11月16日)。 #
- GPQA Diamondは飽和しています:5位のモデルのスコアは95.4%です(BenchLeader、2026年11月16日)。 #
- ARC-AGI-2は飽和しています:5位のモデルのスコアは93.3%です(BenchLeader、2026年11月16日)。 #
- Humanity's Last Examはまだ現役です:首位のスコアは54.8%です(BenchLeader、2026年11月16日)。 #
- 10モデル以上の結果がある現役のボードで最も難しいのは、FrontierMath Erdős(最高スコア4.4%)、FORTRESS(最高スコア5.8%)です(BenchLeader、2026年11月16日)。 #
カテゴリ別の飽和状況
| カテゴリ | 飽和 | 飽和に近い | 現役 | 更新停止 | 合計 |
|---|---|---|---|---|---|
| 推論 | 9 | 3 | 18 | 8 | 38 |
| コーディング | 5 | 8 | 38 | 2 | 53 |
| エージェント・ツール | 2 | 6 | 60 | 1 | 69 |
| 数学 | 11 | – | 8 | 2 | 21 |
| 知識 | 5 | 7 | 21 | 4 | 37 |
| 指示追従 | 1 | 3 | 4 | – | 8 |
| 人間の評価 | – | – | 6 | 1 | 7 |
| マルチモーダル | – | 7 | 14 | 6 | 27 |
| 長文コンテキスト | – | 2 | 3 | – | 5 |
| 総合 | – | 2 | 13 | – | 15 |
| 安全性・誠実さ | 1 | 1 | 2 | – | 4 |
| メタデータ | – | – | 1 | – | 1 |
| すべて | 34 | 39 | 188 | 24 | 285 |
飽和したベンチマーク(34)
5位のモデルのスコアが90%以上です。各モデルは最高スコアで1回だけ数えます。
飽和に近いベンチマーク(39)
首位が90%以上、または5位のモデルが80%以上です。
現役で最も難しいベンチマーク
10モデル以上の結果があるパーセント表示の現役ボードを、首位のスコアが低い順に並べています。
| ベンチマーク | カテゴリ | 5位 | トップ | 首位のスコア | モデル |
|---|---|---|---|---|---|
| FrontierMath Erdős | 数学 | 2.9% | GPT-6.1 Sol | 4.4% | 15 |
| FORTRESS | 安全性・誠実さ | 9.6% | Claude Opus 5.5 | 5.8% | 83 |
| PropensityBench | 安全性・誠実さ | 33.2% | o3 | 10.5% | 14 |
| Harvey LAB-AA v1.1 | エージェント・ツール | 8.6% | Muse Wonder Full | 13.1% | 33 |
| BTF-3 | 推論 | 14.1% | GLM 5.3 Flash | 14.9% | 13 |
| GDPx | エージェント・ツール | 9% | Claude Fable 5.2 | 16.4% | 21 |
| ProgramBench | コーディング | 5.5% | Claude Fable 5.2 | 19% | 65 |
| CL-bench Life | 推論 | 16.9% | GPT-5.5 | 22.2% | 17 |
| SciPredict | 推論 | 22.2% | Gemini 3 Pro | 25.3% | 15 |
| Harvey's Legal Agent Benchmark v1 | エージェント・ツール | 19.6% | Muse Spark 1.2 | 25.4% | 80 |
後継のベンチマーク
飽和または更新停止したボードについて、同じ能力を測り、上位モデルの差がまだつく現役のベンチマークを挙げています。
- GPQA Diamond (AA) (飽和) → Humanity's Last Exam、CritPt
- τ²-Bench Telecom (AA) (飽和) → τ³-Banking (AA)、Terminal-Bench
- GPQA Diamond (飽和) → Humanity's Last Exam、CritPt
- OTIS Mock AIME (飽和) → AIME 2026、FrontierMath Tiers 1–3
- ARC-AGI-1 (飽和) → ARC-AGI-2、ARC-AGI-3
- GPQA Diamond (Vals) (飽和) → Humanity's Last Exam、CritPt
- AIME (Vals) (飽和) → AIME 2026、FrontierMath Tiers 1–3
- MedQA (飽和) → MedScribe、AA-Omniscience v1.1
- MGSM (飽和) → FrontierMath Tiers 1–3、AIME 2026
- IFEval (HELM) (飽和) → IFBench、MultiChallenge
- MATH 500 (飽和) → FrontierMath Tiers 1–3、AIME 2026
- MMLU (更新停止) → MMLU-Pro、GPQA Diamond、Humanity's Last Exam
- MATH Level 5 (更新停止) → FrontierMath Tiers 1–3、HMMT February 2026
- ARC (AI2 Challenge) (更新停止) → ARC-AGI-2、GPQA Diamond
- WinoGrande (更新停止) → SimpleBench、Humanity's Last Exam
数値の算出方法
BenchLeaderが飽和を判定するのは、10モデル以上の結果があるパーセント表示のベンチマークだけです。「飽和」は5位のモデル(1モデルにつき最高スコア1件)が90%以上で、上位の差がノイズにすぎない状態、「飽和に近い」は首位が90%以上か5位が80%以上の状態、「更新停止」は365日を超えて新しい結果がない状態です。それ以外のベンチマーク(Eloレーティング、金額、小規模なボード)は、更新停止でない限り「現役」です。件数はBenchLeaderが48の公開元から追跡しているベンチマークで、公開されているすべてのベンチマークではありません。
首位のモデルが90%を超えた時点でベンチマークを飽和とみなす集計サイトもあります。BenchLeaderは5位のモデルを基準にしているため、1件の突出した結果だけでボードが飽和扱いになることはありません。ステータスはベンチマーク一覧に表示しているものと同じです。
このグラフを使う
これらの件数はBenchLeader独自のもので、CC BY 4.0のもとで自由に再利用できます。その際は、このページへのリンクでBenchLeaderをクレジットしてください。 表とCSVに含まれるベンチマークのスコアには、各ベンチマーク公開元の利用条件が適用されます。
埋め込みコード
<figure><a href="https://www.benchleader.com/ja/stats/benchmark-saturation"><img src="https://www.benchleader.com/stats/benchmark-saturation.svg" alt="BenchLeaderが追跡する285件のベンチマークのうち、34件が飽和、39件が飽和に近い状態です。上位モデルのスコアが上限に近すぎて、差を見分けられません。" width="760"></a><figcaption>出典: <a href="https://www.benchleader.com/ja/stats/benchmark-saturation">BenchLeader</a>, CC BY 4.0</figcaption></figure>引用
BenchLeader「AIベンチマークの飽和状況の統計」2026年11月16日時点のデータ、https://www.benchleader.com/ja/stats/benchmark-saturationよくある質問
- ベンチマークが飽和するとはどういう意味ですか?
- 最上位のモデルがどれも上限近くのスコアを出し、モデル間の差がノイズにすぎなくなった状態です。BenchLeaderは、10モデル以上の結果があるパーセント表示のボードについて、5位のモデルが90%以上なら「飽和」、首位が90%を超えるか5位が80%を超えたら「飽和に近い」としています。
- 飽和したAIベンチマークはいくつありますか?
- BenchLeaderが追跡する285件のベンチマークのうち、34件が飽和、39件が飽和に近い状態です。上位モデルのスコアが上限に近すぎて、差を見分けられません。残りは現役が188件、更新停止が24件です。
- 最も難しいAIベンチマークは?
- 10モデル以上の結果がある現役のボードでは、FrontierMath Erdős(最高スコア4.4%)、FORTRESS(最高スコア5.8%)です。
- なぜ首位ではなく5位のモデルを基準にするのですか?
- 首位のモデルが90%を超えた時点でベンチマークを飽和とみなす集計サイトもあります。BenchLeaderは5位のモデルを基準にしているため、1件の突出した結果だけでボードが飽和扱いになることはありません。