谁在赢得 AI 竞赛?
数据截至 2026年11月16日 · 最后更新于 · BenchLeader
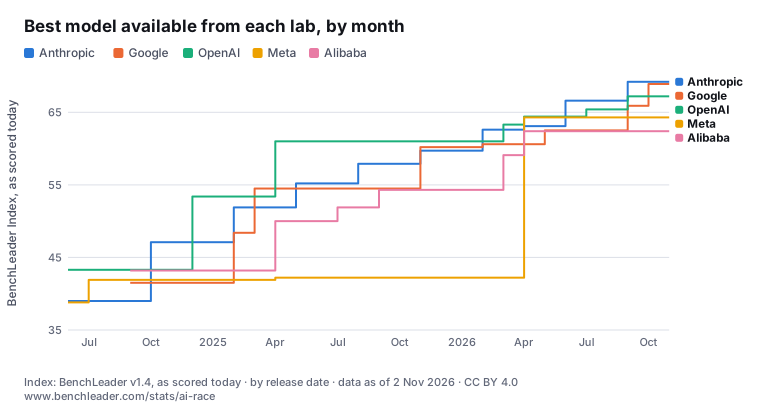
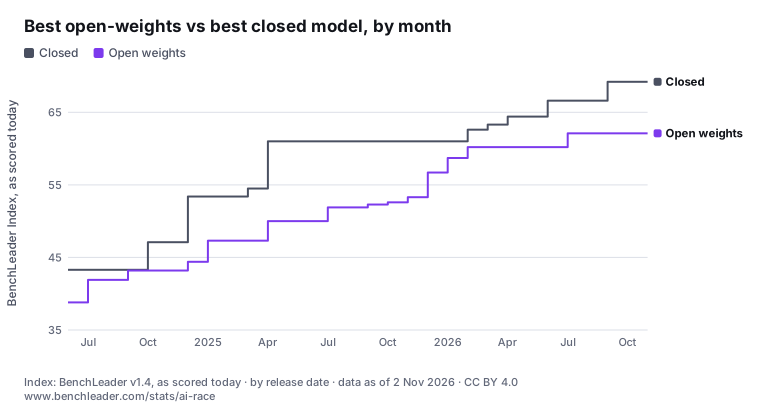
按 BenchLeader Index,目前可用的最佳 AI 模型是 Anthropic 的 Claude Fable 5.2(72.7),自 2026年11月起保持领先;自 2024年6月以来,第一名已易主 13 次。保持领先最久的提供商是 OpenAI,累计 16 个月。最佳开放权重模型 Moonshot AI 的 Kimi K3.1 Pro 得分 61.8,落后最佳闭源模型 10.9 分;2024年6月时差距为 4.1 分。
关键数据
每条数据都有独立链接(#),可直接引用。
- Anthropic 的 Claude Fable 5.2 以 72.7 位居 BenchLeader Index 第一,自 2026年11月起一直是可用的最佳模型(BenchLeader,2026年11月16日)。 #
- 按今天的分数沿发布日期回溯,自 2024年6月以来,第一名在 5 家提供商之间易主 13 次:OpenAI 16 个月、Anthropic 9 个月、Google 2 个月、Meta 2 个月和 Alibaba 1 个月(BenchLeader,2026年11月16日)。 #
- 领先时间最长的是 OpenAI 的 o3:2025年4月至2026年1月,共 10 个月(BenchLeader,2026年11月16日)。 #
- 最佳开放权重模型 Moonshot AI 的 Kimi K3.1 Pro 得分 61.8,落后最佳闭源模型 10.9 分;2024年6月时差距为 4.1 分(BenchLeader,2026年11月16日)。 #
- 自 2024年6月以来,开放权重模型在 1 个月中是可用的最佳模型(BenchLeader,2026年11月16日)。 #
2024年6月以来的每一次领先
每个月可用的最佳模型,按每段领先期列出,最新的在前。按领先月数:OpenAI 16、Anthropic 9、Google 2、Meta 2、Alibaba 1。
| 领先期间 | 模型 | 当前 Index | 月数 |
|---|---|---|---|
| 2026年11月(至今) | Claude Fable 5.2 Anthropic | 72.7 | 1 |
| 2026年10月 | Gemini 4 Carbon Google | 68.9 | 1 |
| 2026年9月 | Claude Opus 5.5 Anthropic | 68.4 | 1 |
| 2026年6月至2026年8月 | Claude Fable 5 Anthropic | 65.4 | 3 |
| 2026年4月至2026年5月 | Muse Spark Meta | 64.2 | 2 |
| 2026年3月 | GPT-5.4 OpenAI | 63.1 | 1 |
| 2026年2月 | Claude Opus 4.6 Anthropic | 62.5 | 1 |
| 2025年4月至2026年1月 | o3 OpenAI | 60.4 | 10 |
| 2025年3月 | Gemini 2.5 Pro Google | 55.2 | 1 |
| 2025年2月 | Claude 3.7 Sonnet Anthropic | 52.9 | 1 |
| 2024年12月至2025年1月 | o1 OpenAI | 52.5 | 2 |
| 2024年10月至2024年11月 | Claude 3.5 Sonnet Anthropic | 46.8 | 2 |
| 2024年9月 | Qwen2.5 72B Alibaba开放权重 | 43.1 | 1 |
| 2024年6月至2024年8月 | GPT-4o OpenAI | 42.8 | 3 |
开放权重与闭源对比
每个月可用的最佳开放权重模型和最佳闭源模型。两条线之间的差距,就是自行部署权重的人落后了多少。
这些数字是怎么得出的
按发布日期回溯:对每个月,取截至月底已发布的模型,用今天的 BenchLeader Index 评分。它反映的是按现在的测量谁领先,而不是当时测得的结果。只计入至少有 10 项第三方结果的模型,因此只在少数排行榜上有成绩的模型无法登顶;BenchLeader 已不再追踪的模型也不在其中。
一两分的领先在 Index 的误差范围之内,详见方法说明。图中列出的是今天最佳模型得分最高的五家实验室。
使用此图表
这些数量是 BenchLeader 自己的数据,可依 CC BY 4.0 自由使用:请注明 BenchLeader 并链接到本页。 CC BY 4.0(请链接到 https://www.benchleader.com/stats/ai-race 注明出处):按今天评分得出的 BenchLeader Index 数值,按发布月份排列。不含任何基准测试分数。
嵌入代码
<figure><a href="https://www.benchleader.com/zh/stats/ai-race"><img src="https://www.benchleader.com/stats/ai-race.svg" alt="按 BenchLeader Index,目前可用的最佳 AI 模型是 Anthropic 的 Claude Fable 5.2(72.7),自 2026年11月起保持领先;自 2024年6月以来,第一名已易主 13 次。" width="760"></a><figcaption>来源: <a href="https://www.benchleader.com/zh/stats/ai-race">BenchLeader</a>, CC BY 4.0</figcaption></figure>引用格式
BenchLeader,《AI 竞赛:每月最佳 AI 模型》,数据截至 2026年11月16日,https://www.benchleader.com/zh/stats/ai-race。常见问题
- 谁在赢得 AI 竞赛?
- 按 BenchLeader Index,目前可用的最佳 AI 模型是 Anthropic 的 Claude Fable 5.2(72.7),自 2026年11月起保持领先;自 2024年6月以来,第一名已易主 13 次。自 2024年6月以来的领先月数:OpenAI 16 个月、Anthropic 9 个月、Google 2 个月、Meta 2 个月和 Alibaba 1 个月。
- 最佳 AI 模型多久换一次?
- 自 2024年6月以来的 30 个月里,第一名更替了 13 次,平均每次领先约 2 个月。最长的是 o3,共 10 个月。
- 开放权重模型落后多少?
- 最佳开放权重模型 Moonshot AI 的 Kimi K3.1 Pro 得分 61.8,落后最佳闭源模型 10.9 分;2024年6月时差距为 4.1 分。
- 这条时间线是怎么得出的?
- 对每个月,取截至月底已发布的模型中,在今天的 BenchLeader Index 上得分最高的一个。它按今天的分数回溯,而不是当时测得的分数;并且只计入至少有 10 项第三方结果的模型,因此只在少数排行榜上有成绩的模型无法登顶。BenchLeader 已不再追踪的模型不在其中。一两分的领先在 Index 的误差范围之内。