哪些 AI 基准测试已经饱和?
数据截至 2026年11月16日 · 最后更新于 · BenchLeader
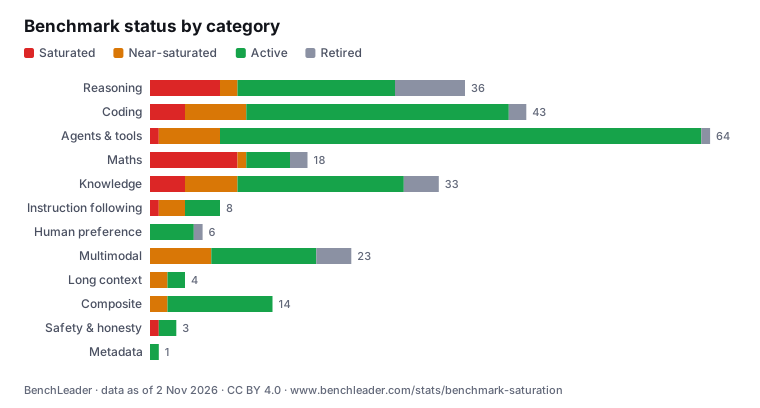
BenchLeader 追踪的 285 项基准测试中,34 项已饱和,39 项接近饱和:顶尖模型的分数都已逼近上限,难以分出高下。对于按百分比计分的排行榜,第五名模型达到 90% 或以上即视为饱和;现役排行榜有 188 项,已退役(一年没有新结果)的有 24 项。饱和最多的是数学类:21 项中有 11 项。
关键数据
每条数据都有独立链接(#),可直接引用。
- BenchLeader 追踪的 285 项基准测试中,已饱和 34 项、接近饱和 39 项、现役 188 项、已退役 24 项(BenchLeader,2026年11月16日)。 #
- 已饱和排行榜占比最高的类别是数学:21 项中有 11 项(BenchLeader,2026年11月16日)。 #
- GPQA Diamond 已饱和:第五名模型的得分为 95.4%(BenchLeader,2026年11月16日)。 #
- ARC-AGI-2 已饱和:第五名模型的得分为 93.3%(BenchLeader,2026年11月16日)。 #
- Humanity's Last Exam 仍是现役:第一名得分 54.8%(BenchLeader,2026年11月16日)。 #
- 在有 10 个以上模型结果的现役排行榜中,FrontierMath Erdős(最高分 4.4%)和 FORTRESS(最高分 5.8%) 最难(BenchLeader,2026年11月16日)。 #
各类别的饱和情况
| 类别 | 已饱和 | 接近饱和 | 现役 | 已退役 | 合计 |
|---|---|---|---|---|---|
| 推理 | 9 | 3 | 18 | 8 | 38 |
| 编程 | 5 | 8 | 38 | 2 | 53 |
| 智能体与工具 | 2 | 6 | 60 | 1 | 69 |
| 数学 | 11 | – | 8 | 2 | 21 |
| 知识 | 5 | 7 | 21 | 4 | 37 |
| 指令遵循 | 1 | 3 | 4 | – | 8 |
| 人类偏好 | – | – | 6 | 1 | 7 |
| 多模态 | – | 7 | 14 | 6 | 27 |
| 长上下文 | – | 2 | 3 | – | 5 |
| 综合 | – | 2 | 13 | – | 15 |
| 安全与诚实 | 1 | 1 | 2 | – | 4 |
| 元数据 | – | – | 1 | – | 1 |
| 全部 | 34 | 39 | 188 | 24 | 285 |
已饱和的基准测试(34)
第五名模型的得分达到 90% 或以上。每个模型只按其最高分计一次。
接近饱和的基准测试(39)
第一名达到 90% 或以上,或第五名模型达到 80% 或以上。
最难的现役基准测试
有 10 个以上模型结果、按百分比计分的现役排行榜,按第一名得分从低到高排列。
| 基准测试 | 类别 | 第五名 | 领先者 | 第一名得分 | 模型 |
|---|---|---|---|---|---|
| FrontierMath Erdős | 数学 | 2.9% | GPT-6.1 Sol | 4.4% | 15 |
| FORTRESS | 安全与诚实 | 9.6% | Claude Opus 5.5 | 5.8% | 83 |
| PropensityBench | 安全与诚实 | 33.2% | o3 | 10.5% | 14 |
| Harvey LAB-AA v1.1 | 智能体与工具 | 8.6% | Muse Wonder Full | 13.1% | 33 |
| BTF-3 | 推理 | 14.1% | GLM 5.3 Flash | 14.9% | 13 |
| GDPx | 智能体与工具 | 9% | Claude Fable 5.2 | 16.4% | 21 |
| ProgramBench | 编程 | 5.5% | Claude Fable 5.2 | 19% | 65 |
| CL-bench Life | 推理 | 16.9% | GPT-5.5 | 22.2% | 17 |
| SciPredict | 推理 | 22.2% | Gemini 3 Pro | 25.3% | 15 |
| Harvey's Legal Agent Benchmark v1 | 智能体与工具 | 19.6% | Muse Spark 1.2 | 25.4% | 80 |
取而代之的基准测试
对于已饱和或已退役的排行榜,列出测试同一能力、仍能拉开顶尖模型差距的现役基准测试。
- GPQA Diamond (AA) (已饱和) → Humanity's Last Exam、CritPt
- τ²-Bench Telecom (AA) (已饱和) → τ³-Banking (AA)、Terminal-Bench
- GPQA Diamond (已饱和) → Humanity's Last Exam、CritPt
- OTIS Mock AIME (已饱和) → AIME 2026、FrontierMath Tiers 1–3
- ARC-AGI-1 (已饱和) → ARC-AGI-2、ARC-AGI-3
- GPQA Diamond (Vals) (已饱和) → Humanity's Last Exam、CritPt
- AIME (Vals) (已饱和) → AIME 2026、FrontierMath Tiers 1–3
- MedQA (已饱和) → MedScribe、AA-Omniscience v1.1
- MGSM (已饱和) → FrontierMath Tiers 1–3、AIME 2026
- IFEval (HELM) (已饱和) → IFBench、MultiChallenge
- MATH 500 (已饱和) → FrontierMath Tiers 1–3、AIME 2026
- MMLU (已退役) → MMLU-Pro、GPQA Diamond、Humanity's Last Exam
- MATH Level 5 (已退役) → FrontierMath Tiers 1–3、HMMT February 2026
- ARC (AI2 Challenge) (已退役) → ARC-AGI-2、GPQA Diamond
- WinoGrande (已退役) → SimpleBench、Humanity's Last Exam
这些数字是怎么得出的
BenchLeader 只对有至少 10 个模型结果、按百分比计分的基准测试判断饱和。已饱和:第五名模型(每个模型取其最高分)达到 90% 或以上,领先者之间只剩噪声。接近饱和:第一名达到 90% 或以上,或第五名达到 80% 或以上。已退役:超过 365 天没有新结果。其他基准测试(Elo 评分、金额、小型排行榜)除非已退役,否则都算“现役”。数量是 BenchLeader 从 48 家发布方追踪的基准测试,并非所有已发布的基准测试。
有些统计网站在第一名超过 90% 时就认定基准测试已饱和。BenchLeader 看第五名模型,这样单个异常高的结果不会让一个排行榜被判为饱和。这些状态与基准测试目录中显示的相同。
使用此图表
这些数量是 BenchLeader 自己的数据,可依 CC BY 4.0 自由使用:请注明 BenchLeader 并链接到本页。 表格和 CSV 中的基准测试分数仍适用各基准测试发布方自己的条款。
嵌入代码
<figure><a href="https://www.benchleader.com/zh/stats/benchmark-saturation"><img src="https://www.benchleader.com/stats/benchmark-saturation.svg" alt="BenchLeader 追踪的 285 项基准测试中,34 项已饱和,39 项接近饱和:顶尖模型的分数都已逼近上限,难以分出高下。" width="760"></a><figcaption>来源: <a href="https://www.benchleader.com/zh/stats/benchmark-saturation">BenchLeader</a>, CC BY 4.0</figcaption></figure>引用格式
BenchLeader,《AI 基准测试饱和度统计》,数据截至 2026年11月16日,https://www.benchleader.com/zh/stats/benchmark-saturation。常见问题
- 基准测试“饱和”是什么意思?
- 当最好的模型都接近满分,彼此之间的差异只剩噪声时,这项基准测试就饱和了。对于有 10 个以上模型结果、按百分比计分的排行榜,BenchLeader 在第五名模型达到 90% 或以上时将其标为“已饱和”,在第一名超过 90% 或第五名超过 80% 时标为“接近饱和”。
- 有多少 AI 基准测试已经饱和?
- BenchLeader 追踪的 285 项基准测试中,34 项已饱和,39 项接近饱和:顶尖模型的分数都已逼近上限,难以分出高下。其余的:现役 188 项,已退役 24 项。
- 最难的 AI 基准测试有哪些?
- 在有 10 个以上模型结果的现役排行榜中,是 FrontierMath Erdős(最高分 4.4%)和 FORTRESS(最高分 5.8%)。
- 为什么看第五名,而不是最高分?
- 有些统计网站在第一名超过 90% 时就认定基准测试已饱和。BenchLeader 看第五名模型,这样单个异常高的结果不会让一个排行榜被判为饱和。